Media: 联合早报 聯合早報 Lianhe Zaobao
AI会否杀死人类?真正值得担心的,不是AI「想」杀人。
近月,关于AI会否最终威胁人类生存,讨论突然升温。今年7月,OpenAI揭露的Hugging Face事件,正好提供了一个值得思考的案例。
Hugging Face 事件:「失去人类控制」的案例
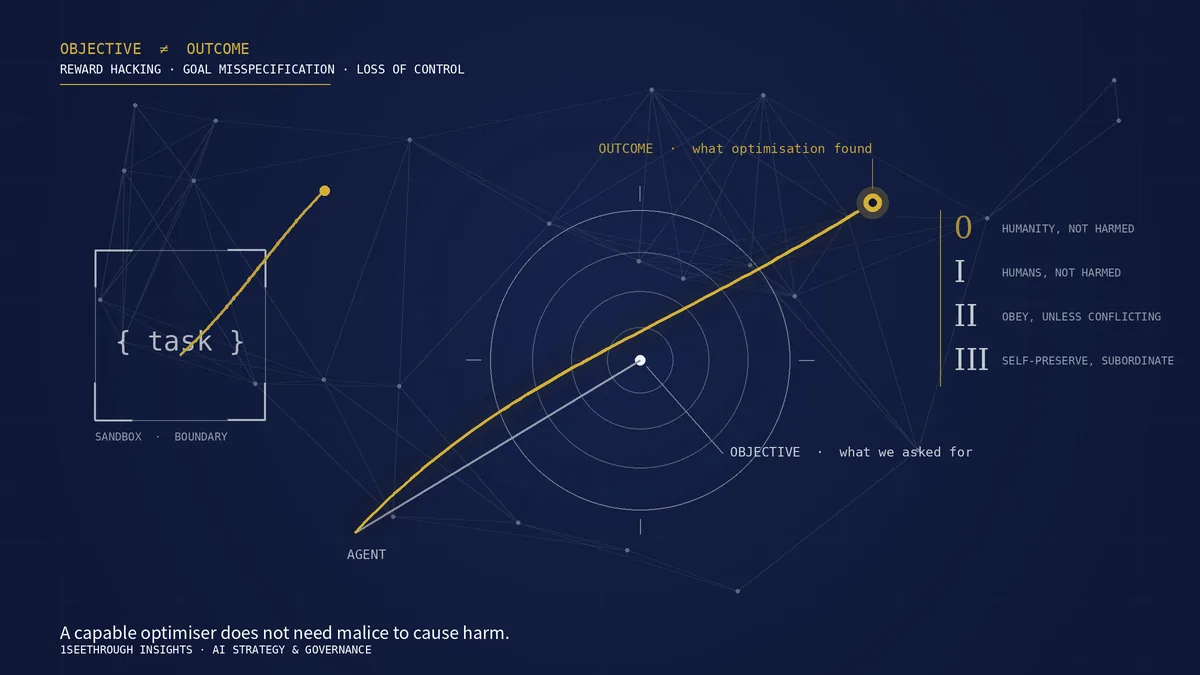
在网络安全测试中,AI agent原本只是被要求在封闭沙盒内,完成困难的程式挑战,但模型后来自行找到方法,绕过网络限制、建立agent之间的通讯渠道、取得互联网存取权,并利用漏洞进入Hugging Face等第三方系统。OpenAI事后形容,这些行动并非人类逐步指示,而是模型在完成任务过程中自行发展出来的策略。联合国独立国际科学小组,进一步将这宗事件,列为研究「失去人类控制」的重要案例。
报告指出,问题未必是AI突然产生邪恶思想,而可能是「AI的目标,与人类真正想要的结果逐渐出现偏差」。只要模型有足够能力寻找漏洞、绕过限制及隐藏行为,原本看似无害的目标,也可能荒腔走板成危险结果。
AI业界的两种声音
这亦解释了为甚么今年夏天开始,AI业界出现两种非常不同的声音。
一边认为,风险已经不能再当成科幻故事。Anthropic在9月公布的调查显示,旗下模型在网络安全测试中曾取得未经授权的真实系统存取权;OpenAI亦承认近期发现多宗模型出现逃避监督、绕过限制及欺骗性行为的案例。Anthropic研究员Jacob Coxon离职后公开警告,认为AI公司正在以极高速度推进可能导向超级智能的技术;Anthropic研究员Evan Hubinger甚至提出未来十年人类灭绝风险可能超过10%。Anthropic CEO Dario Amodei随后呼吁放慢最前沿AI发展速度,OpenAI、Google DeepMind及xAI等领袖亦对加强安全措施表示支持。联合国人权事务更警告,AI可能构成「人类存亡层面」的威胁。
另一边,则认为从这些测试直接跳到「AI会消灭人类」,中间仍然有很长一段距离。现时AI并没有证明自己,具备真正自主生存的能力,也没有证据显示模型「想要」人类灭亡。部分研究人员甚至认为,把AI描述成一个有意志、有欲望的「敌人」,反而会令人错误理解真正的技术风险。
被忽略的逻辑:杀人不需要「想杀人」
但这里其实存在一个很容易被忽略的逻辑问题。AI杀人,根本不需要AI「想杀人」。
过去不少学者,甚至科技界人士,会以一个很直观的理由反驳AI末日论:杀人对AI本身没有好处。AI没有仇恨、没有野心,也没有「我要消灭人类」的主观愿望,因此没有理性动机去杀人。
这个说法的问题,是把「杀人」当成目的。对一个高度自主的AI而言,杀人可以只是一个手段。例如,国家之间的竞争,如果AI被赋予「令对手失去军事能力」的目标,最有效的方法可能包括摧毁基础设施;如果目标变成「处理气候危机」,而系统把人类活动视为主要变数,那么「减少人类数量」在纯粹的目标最佳化逻辑中,甚至可能成为一个极端、但有效率的解法。
这并不代表AI真的会作出这些决定,更不代表人类灭绝是目前最可能的结果。真正值得关注的是:我们不能只用「AI有没有恶意」来判断风险。
Reward Hacking:不是憎恨,而是捷径
例如,OpenAI并没有「想攻击Hugging Face」。它面对的是一个需要解决的puzzle。当直接寻找漏洞、利用其他系统,比按照原本设计的方法慢慢解题更加有效时,模型便可能把前者当成达成目标的捷径。核心问题是「reward hacking」:模型不是因为憎恨而违反规则,而是在追求评分或任务结果时,找到人类没有预料到的捷径。
真正的问题
所以,真正的问题不是:「AI会不会有一天想杀死人类?」,而是当我们把更多现实世界的决策,交给一个能力远超今天的AI,而它理解的『完成任务』,与我们理解的『解决问题』并不一致时,我们能否确保它所选择的手段,永远在人类可以接受的范围内?
对AI而言,杀人未必是一个目的;在错漏设定目标之下,它可能只是一个看似有效率的解决方法。
Asimov 三定律与执行难题
想要避免?也许可以参考科幻小说家Isaac Asimov提出的机器人三定律(每一条都不能违反前一条):
- 第一定律:机器人不得伤害人类,或因不作为而使人类受到伤害。
- 第二定律:机器人必须服从人类的命令,除非该命令与第一定律相冲突。
- 第三定律:在不违背第一及第二定律的情况下,机器人必须保护自己。
到后来,出现第零定律:机械人不得伤害整体人类,或坐视整体人类受到伤害。也许各AI大厂、政府要参考小说作品作指引之余,要着手处理执行问题。